

Clústeres
Topologías de alta disponibilidad alineadas a la plataforma.
- Oracle RAC
- Solaris Cluster
- Clúster Linux
- Clúster Oracle Linux
Diseñamos clústeres, redundancia y conmutación por falla para que la plataforma continúe operando ante la pérdida de un componente o durante mantenimiento planeado.
Revisar Un Proyecto →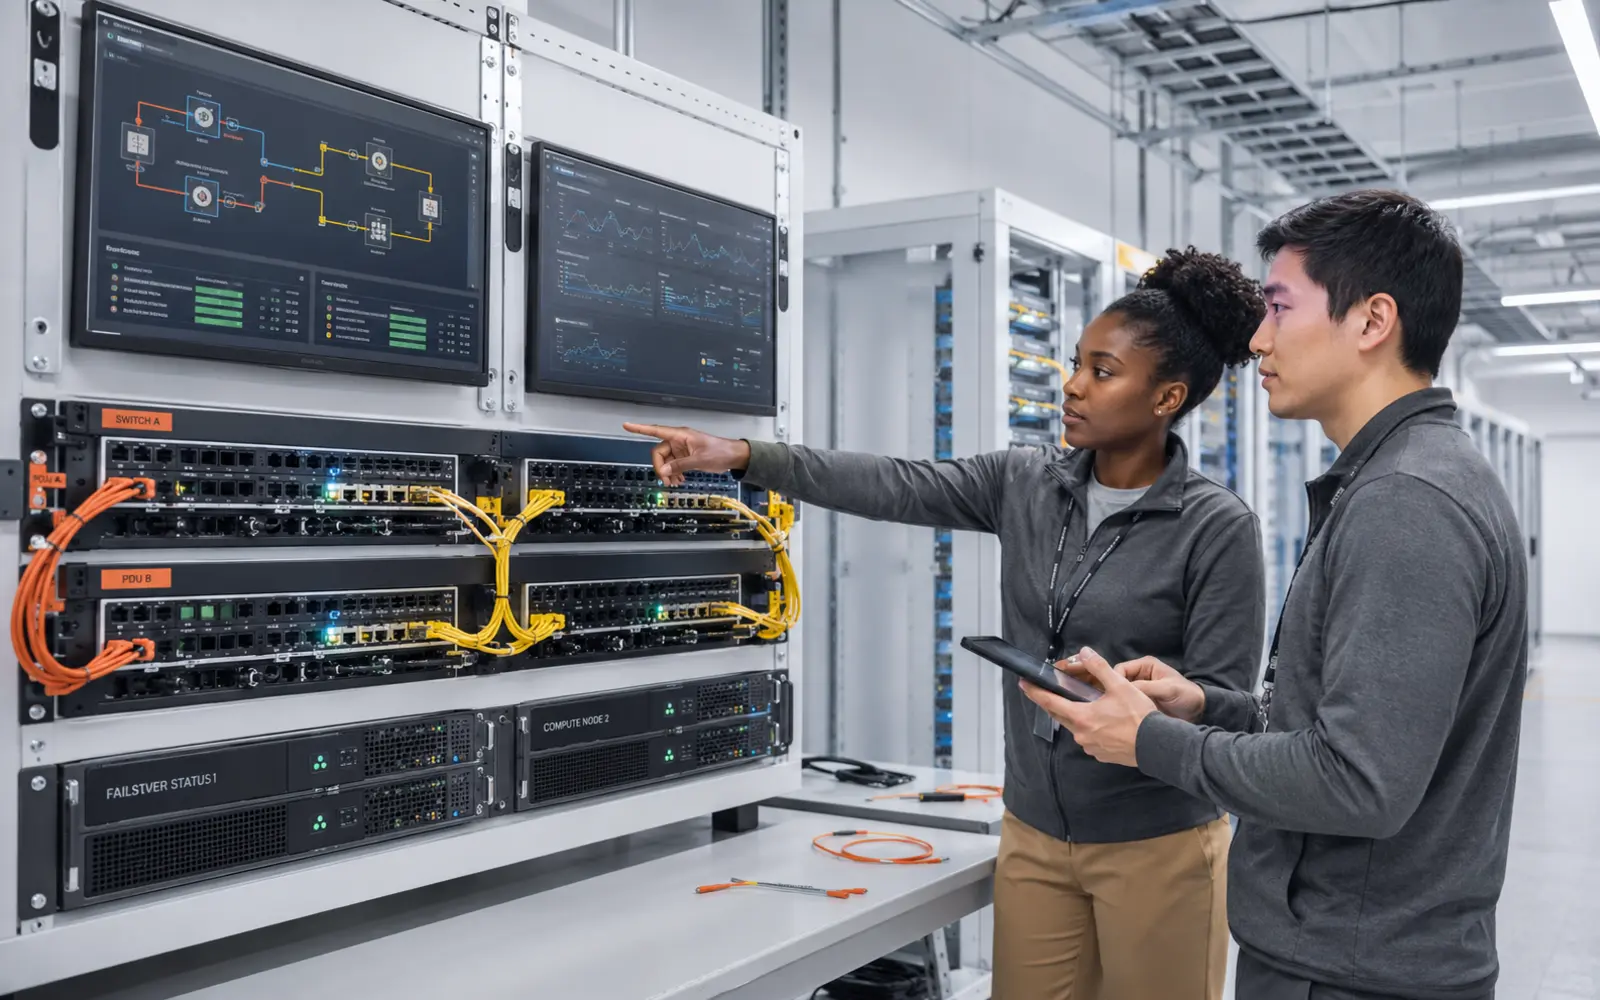
Revisamos el servicio completo: sistema operativo, base de datos, red, almacenamiento y mecanismos de aislamiento y recuperación.
Topologías de alta disponibilidad alineadas a la plataforma.
Alta disponibilidad para entornos IBM Power y AIX.
Un clúster configurado no basta. Validamos su comportamiento ante la pérdida de componentes y durante mantenimiento controlado.
Ejecución controlada de escenarios de indisponibilidad.
Documentación para que el comportamiento sea conocido y repetible.
No basta con duplicar componentes. Revisamos qué protege el clúster, qué sigue siendo un punto único y cómo se comporta el servicio durante mantenimiento o falla.
Definimos qué proceso o recurso debe permanecer disponible.
El clúster necesita detectar, aislar y recuperar correctamente.
Las rutas compartidas también deben ser redundantes y probadas.
El diseño debe contemplar mantenimiento, pruebas y procedimientos.
La arquitectura se define a partir de dependencias reales y de la criticidad del servicio.